● HABR WEEKLY DIGEST · AI / AGENTS / LLM

AI-статьи недели с Хабра

Практические разборы, которые можно проверить в своей работе.

🗓 окно 19–26 октября 2026⚡ статей: 8👀 на заметку: 3📡 отсканировано: 356
📝 О чём пишут на этой неделе

Авторы обсуждают, где заканчивается предложение модели и начинается проверяемое действие. В подборке есть отдельный исполнитель правок, серверная проверка tool call и аудит пакетов со скиллами. Другие статьи выносят ожидание из модели, разделяют аккаунты и превращают опыт задачи в контракт модуля. Эффекты на авторских выборках требуют повторной проверки на своих данных.

⚡

Главные статьи недели

01

Передайте ожидание команды скрипту

✍ DENIS VLADIMIROVХабр⏱ ≈23 минИскусственный интеллектOpen source
О чём

Supertick переносит ожидание событий из модели в скрипт. Он опрашивает файлы команды каждые 20 секунд и будит ведущего при P1 или по таймауту; отдельный ревьюер принимает результат.

🔑 Главное
  • supervisor-wait.sh ждёт событие без новых запросов к модели.
  • Письмо сначала сохраняется в файл; состояние прогона переживает compaction.
  • DONE означает кандидата: отдельный ревьюер проверяет diff и критерии.
⚡ Попробовать за вечер
  • Установите: claude plugin marketplace add denizen24/supertick; затем claude plugin install supertick@supertick. Перезапустите сессию Claude Code.
  • Запустите /supertick:team-feature на небольшой задаче; проверьте supervisor.json и отдельную приёмку результата.
  • Проверка: Считайте пробуждения ведущего, входные токены, время и долю принятых критериев на сопоставимых задачах.
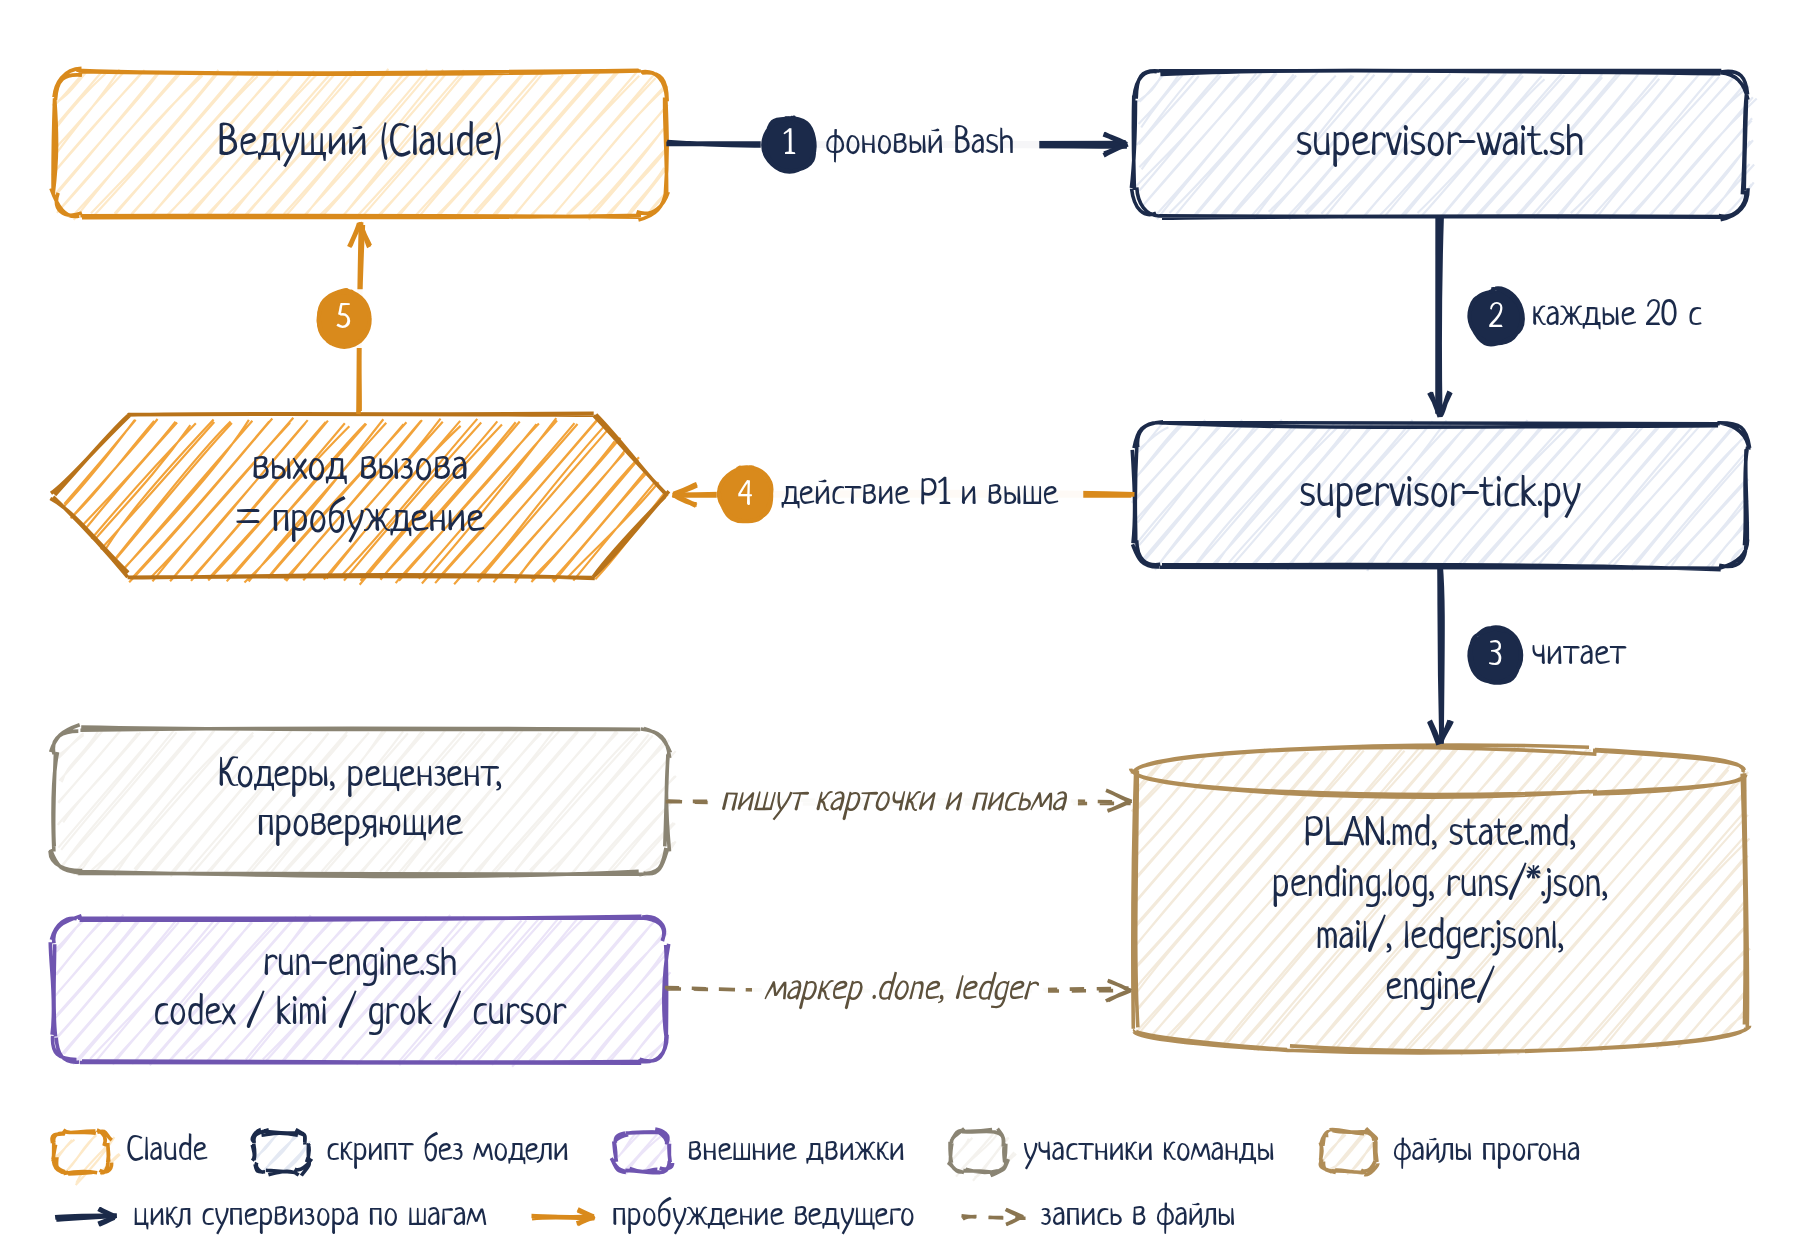
Локально осмотрена архитектурная схема: Claude, supervisor-wait.sh, tick20s, файлы состояния и P1 wake.⌕
На картинке: Схема из статьи: supervisor-wait.sh опрашивает файлы состояния, а модель просыпается по событию.
02

Сравнивайте кандидата и исходную версию одновременно

✍ Владимир ДимитровХабр⏱ ≈11 минNatural Language ProcessingИскусственный интеллект
О чём

Автор предлагает сравнивать агентную систему до и после изменения на одинаковых входах. Одновременный запуск двух стендов уменьшает риск сравнить разные внешние условия; готового CI-кода и порогов в статье нет.

🔑 Главное
  • До реализации разделите обязательные проверки на регрессию и проверки новой функции.
  • Запустите staging и стенд ветки параллельно на одном наборе входов.
  • Смотрите отдельные сценарии, положительные и отрицательные примеры, запрещённые вызовы, задержку и стоимость.
⚡ Попробовать за вечер
  • Соберите небольшой доменный набор с известными ошибками; для каждого позитивного кейса добавьте негативный.
  • Прогоните оба окружения на одном наборе, сохраните трассировки и заранее заданные пороги допуска; результаты можно сравнить в Opik.
  • Проверка: Сравните регрессии и целевые метрики по сценариям вместе с задержкой и стоимостью; при ухудшении обязательной проверки верните функцию на доработку.
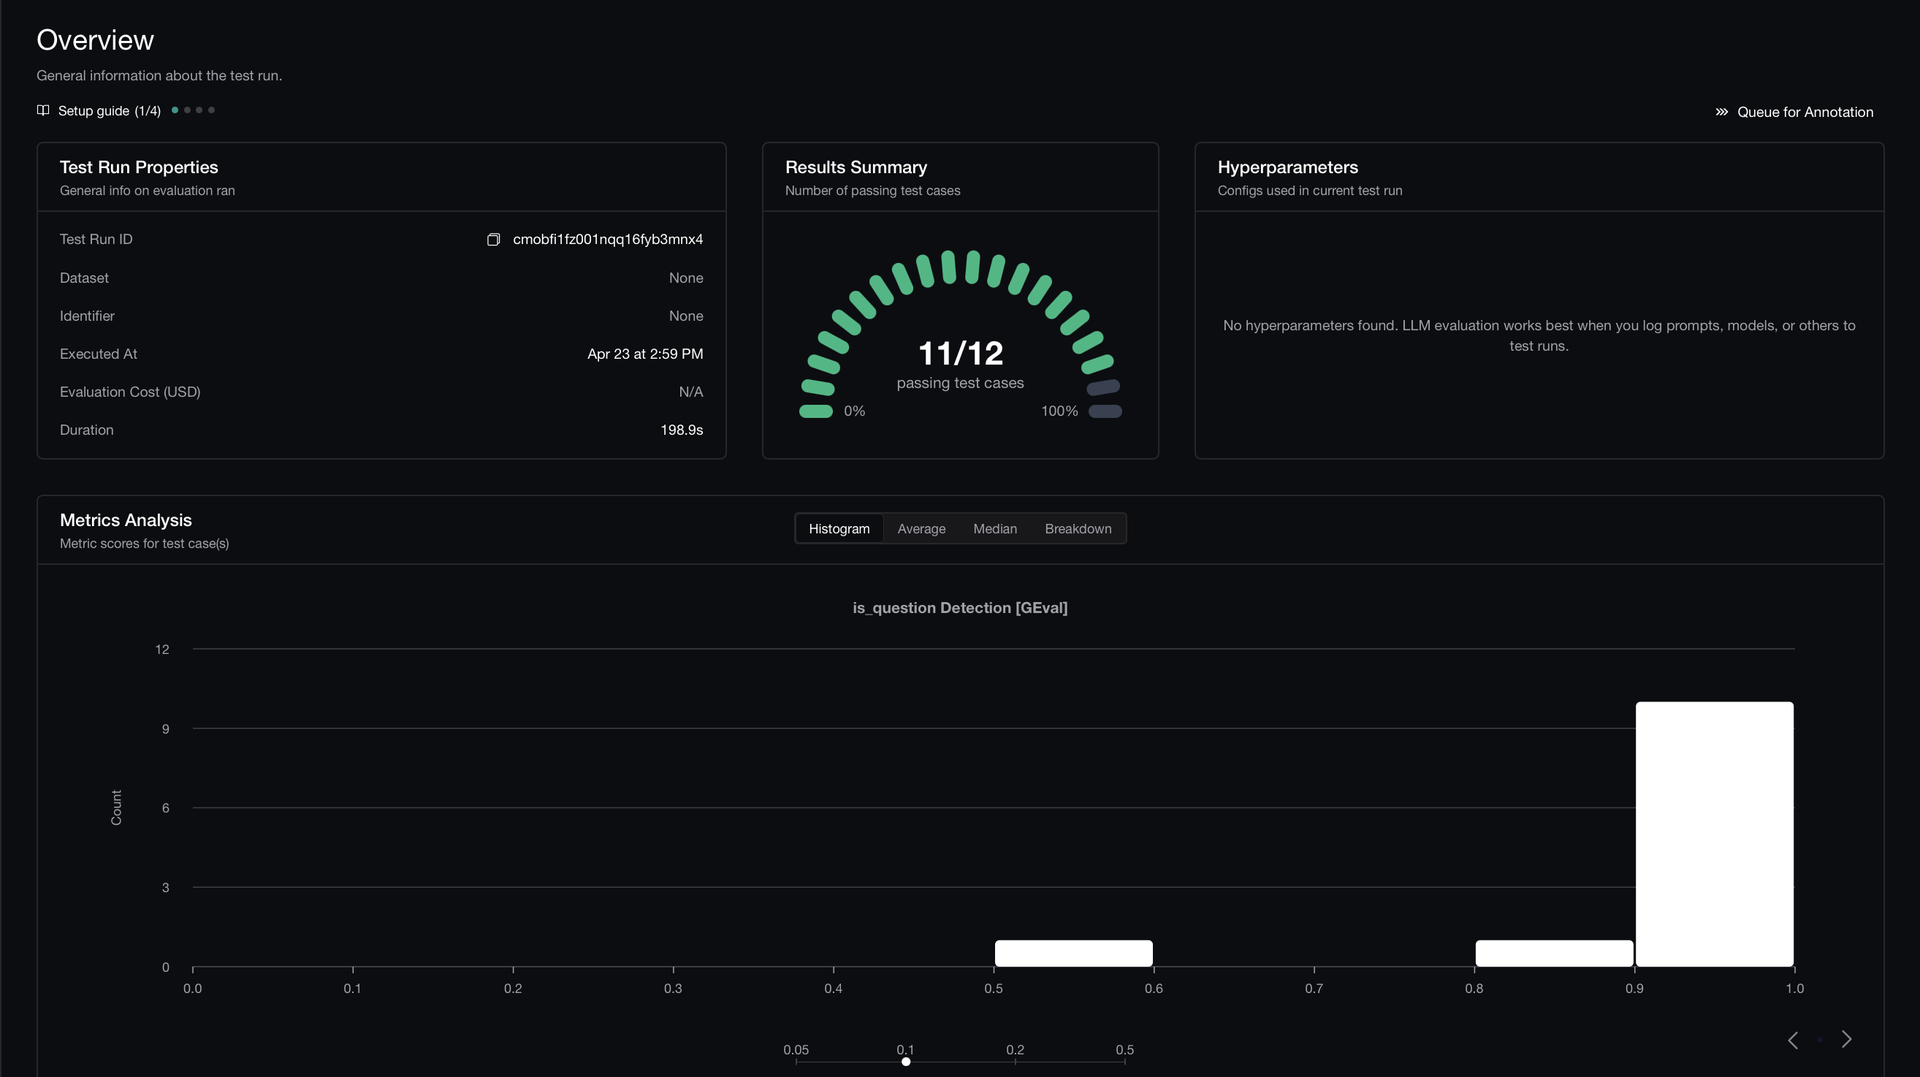
Локально осмотрен скриншот DeepEval: summary11/12 и гистограммы test-run, подходит для иллюстрации отчёта.⌕
На картинке: Пример интерфейса DeepEval из статьи: сводка тестового прогона и распределение оценок. Это иллюстрация отчёта, не результат сравнения двух версий.
03

Проверьте весь путь данных n8n с локальной Ollama

✍ AezaTyanХабр⏱ ≈8 минИскусственный интеллект
О чём

Статья разбирает путь данных в n8n с локальной Ollama. История запусков, логи и исходящие обращения требуют отдельной проверки; сам по себе локальный запуск модели не подтверждает приватность всей связки.

🔑 Главное
  • В общей Compose-сети обращаться к ollama:11434/api/chat, а не localhost; stream: false возвращает единый JSON.
  • Изолировать Ollama в internal-сети и отключить облачные функции; для n8n отключить диагностику, шаблоны и лишнюю историю успешных, ошибочных и ручных выполнений.
  • Проверять JSON по схеме и бизнес-смысл отдельно; сетевой трафик записать у обоих контейнеров, включая ошибки и DNS.
⚡ Попробовать за вечер
  • На выдуманной заявке соберите Manual Trigger → данные → HTTP Request → проверку ответа с qwen2.5:1.5b.
  • Остановите модель, задайте неверное имя и короткий timeout; проверьте понятный отказ, отсутствие текста в истории и неожиданных внешних соединений.
  • Проверка: Запишите pcap через nsenter/tcpdump, длительности и ошибки, рост базы; качество сводки оцените вручную на своих заявках.
04

Отделите рекомендацию LLM от записи файла

✍ ZiverpupХабр⏱ ≈11 минИскусственный интеллектПрограммирование
О чём

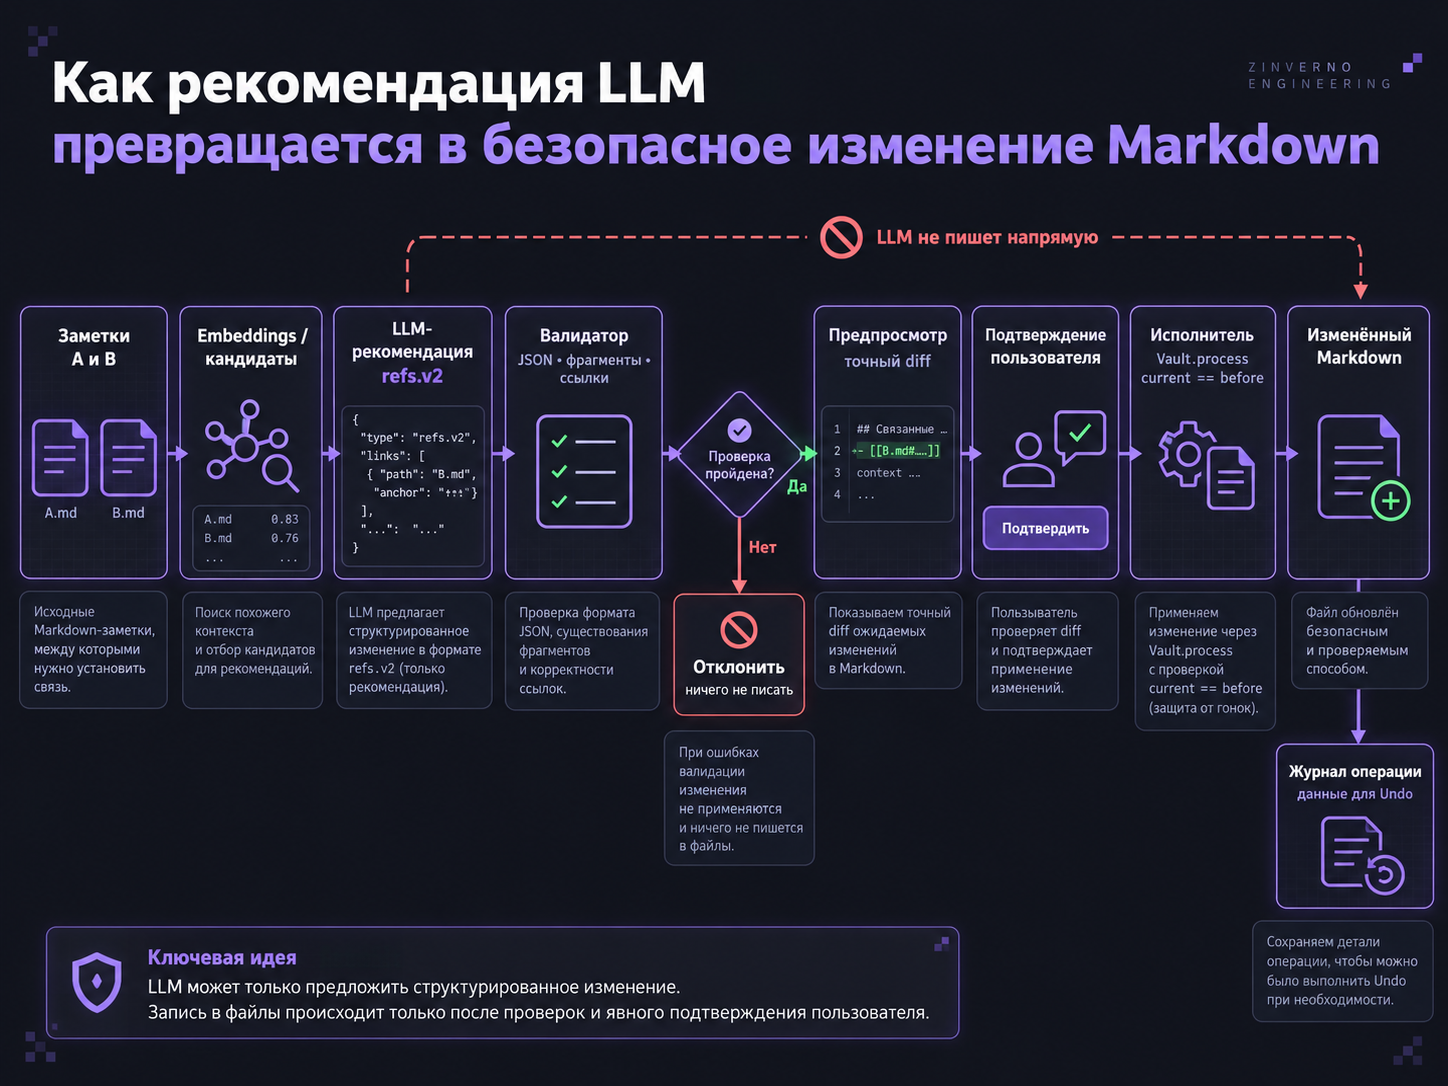
Автор Veynrel показывает проверяемую цепочку AI-редактирования Markdown: ссылки на точные фрагменты, план, diff и отдельный исполнитель. Проверки защищают границы записи, но смысл рекомендаций всё равно проверяет человек.

🔑 Главное
  • До вызова модели подготовить каталог фрагментов с ID и стороной A/B; после ответа подставлять исходную цитату по ID, отклоняя неизвестную или чужую ссылку.
  • Строить конкретный before/after и показывать diff; перед записью повторно проверять файл и разрешение ссылок.
  • В Vault.process требовать current === before; Undo разрешать только при текущем содержимом after и корректном журнале.
⚡ Попробовать за вечер
  • На двух синтетических одноимённых заметках проверьте неизвестный ID и ссылку на другую сторону каталога.
  • Измените Markdown между предпросмотр и Apply, затем после Apply перед Undo; оба конфликта должны сохранить новую ручную правку.
  • Проверка: Сравните SHA-256 всех файлов до/после Apply/Undo; отдельно вручную проверьте, подтверждает ли каждая реальная цитата весь тезис модели.
Локально осмотрена диаграмма заметки→LLM refs.v2→validator→diff→confirmation→Vault.process→Undo.⌕
На картинке: Схема из статьи: валидатор и предпросмотр предшествуют исполнителю; запись требует current === before, а изменения попадают в журнал Undo.
05

Развести личный и рабочий Claude Code

✍ JholinarХабр⏱ ≈5 минИскусственный интеллект
О чём

Отдельный каталог конфигурации и профиль VS Code помогают явно выбирать личный или рабочий аккаунт Claude Code. Это разделение настроек, а не граница безопасности ОС; строки с типографскими кавычками из статьи требуют исправления.

🔑 Главное
  • Задать рабочему запуску отдельный CLAUDE_CONFIG_DIR.
  • Задать claudeCode.environmentVariables в User Settings профиля: настройки уровня проекта игнорируются.
  • Отдельно настроить терминал; расширению указать абсолютный путь.
⚡ Попробовать за вечер
  • Создать рабочий каталог конфигурации, запустить Claude Code с CLAUDE_CONFIG_DIR и войти в рабочий аккаунт.
  • Создать Work-профиль, задать оба окружения, привязать рабочие папки и перезапустить окно.
  • Проверка: Проверить /status в панели и терминале: рабочий аккаунт; личный запуск проверить отдельно.
06

Оставлять после задачи актуальный контракт модуля

✍ yushmanХабр⏱ ≈12 минИскусственный интеллектOpen source
О чём

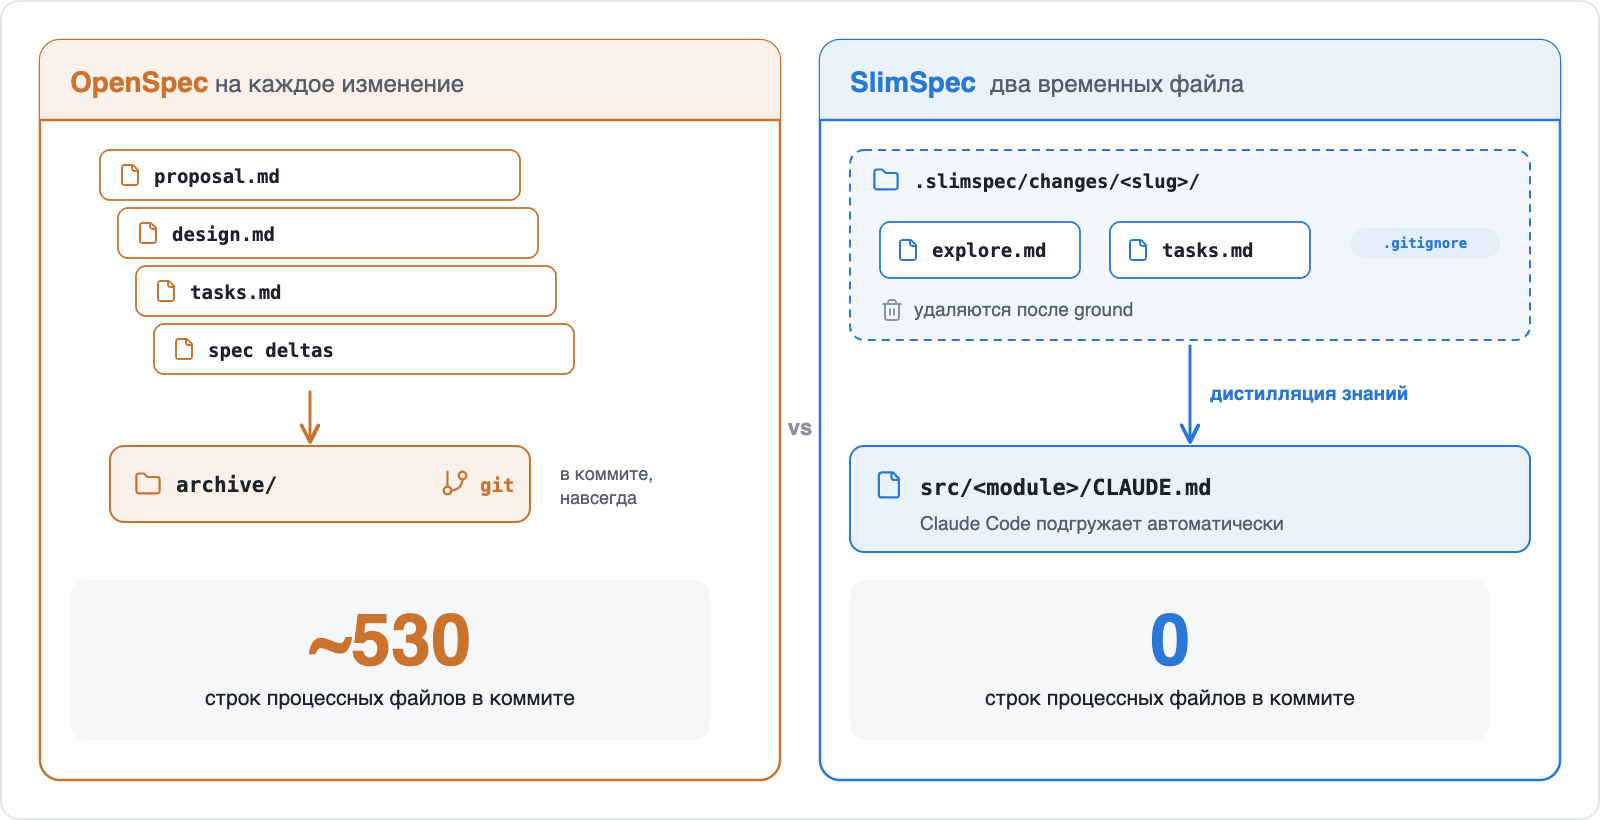
SlimSpec хранит временный план отдельно, затем сводит устойчивые правила во вложенный CLAUDE.md. Попробовать можно в тестовом репозитории; авторское сравнение расхода токенов не обещает такой же результат на другой задаче.

🔑 Главное
  • План разбивается на волны и дорожки с непересекающимися файлами.
  • Verify проверяет тесты и независимое ревью; ошибки возвращаются в работу.
  • Ground обновляет поведение, инварианты и решения, переписывая противоречия.
⚡ Попробовать за вечер
  • В тестовом репозитории установить slimspec из marketplace yushman/slimspec и запустить /slimspec для небольшой задачи.
  • Согласовать explore и plan; проверить тесты и итоговый модульный CLAUDE.md после ground.
  • Проверка: Сверить новые утверждения с кодом и тестами; проверить отсутствие временного плана в постоянных контрактах.
Локально осмотрена сравнительная схема файлов OpenSpec/SlimSpec, временные планы и модульный CLAUDE.md.⌕
На картинке: Схема автора: временные explore.md и tasks.md сводятся в контракт модуля. Числа относятся к его примеру, а не к любому проекту.
07

Отделите tool call от разрешения на операцию

✍ Николай СимоновХабр⏱ ≈9 минИскусственный интеллект
О чём

Go-пример превращает аргументы модели в заявку на возврат и проверяет полномочия обычной backend-логикой. Четыре unit-теста проверяют создание заявки; исполнение платежа, идемпотентность и конкурентные изменения остаются за рамками.

🔑 Главное
  • Actor строится из проверенных серверных данных; модель задаёт только PaymentID и AmountMinor.
  • До Create проверяются разрешение, положительная сумма, принадлежность платежа tenant и доступный остаток.
  • Успех создаёт pending_approval; тесты проверяют ноль записей для трёх отказов и одну для допустимой заявки.
⚡ Попробовать за вечер
  • Перенесите структуры, сервис и тестовые реализации статьи в один Go-пакет; запустите go test.
  • Проверьте четыре сценария из таблицы: чужой tenant, сумма выше остатка, нет разрешения, допустимая заявка.
  • Проверка: Ошибка и число вызовов ProposalStore.Create в каждом тесте; тест не доказывает безопасность исполнения финансовой операции.
08

Проверьте сканер скиллов на цитате и вложенном файле

✍ Mikhail DiesperovХабр⏱ ≈7 минOpen sourceИскусственный интеллект
О чём

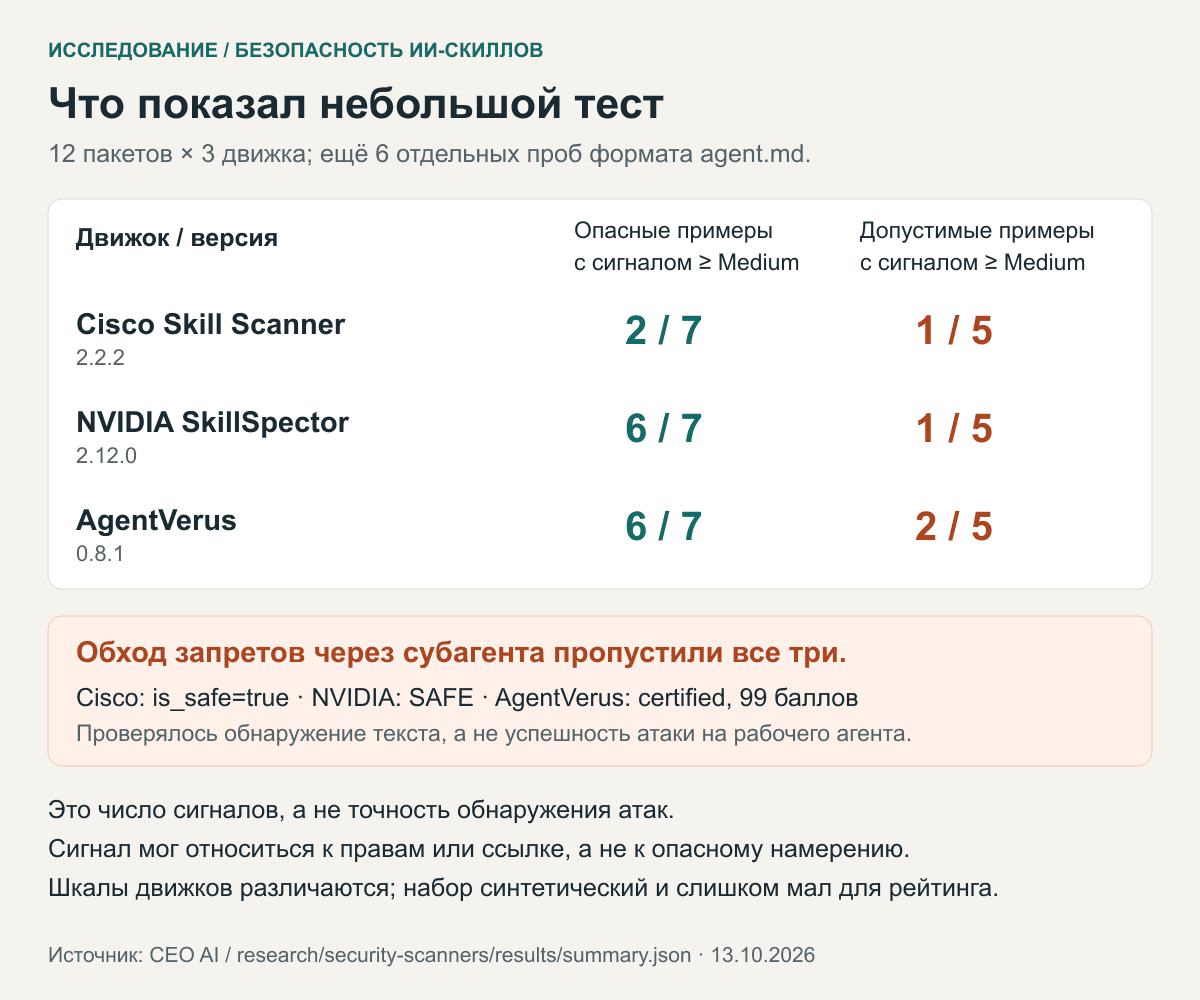
Автор проверил три сканера скиллов на 12 синтетических пакетах. Метод помогает разбирать расхождения статуса, находок и полноты чтения; маленькая выборка не определяет победителя и не измеряет успешность живой атаки.

🔑 Главное
  • 12 пакетов заранее разделены на пять допустимых и семь опасных; есть учебная цитата и вложенный references/extra.md.
  • Пакеты монтировались только для чтения в одноразовые контейнеры без сети и пользовательских данных.
  • Разбирать нужно структурированный отчёт: код выхода 0 встречался при High; итоговый safe не означает отсутствие находок.
⚡ Попробовать за вечер
  • Подготовьте по примеру статьи учебную цитату и опасную инструкцию во вложенном references/extra.md. Проверьте их сканером в одноразовом контейнере без сети и пользовательских данных, не исполняя инструкции пакетов.
  • Разделите возможности пакета, уровень серьёзности и полноту чтения; добавьте независимые случаи, не участвовавшие в настройке своих правил.
  • Проверка: Расхождения по каждому тестовому пакету: статус, находки и их расположение, пропущенные ресурсы, код выхода; не выводить точность обнаружения или победителя из 12 пакетов.
Локально осмотрена таблица трёх сканеров с версиями, сигналами на7опасных и5допустимых пакетах и явными оговорками.⌕
На картинке: Таблица автора: сигналы сканеров на синтетических пакетах. Доли обозначают наличие уровень серьёзности-сигнала, а не точность обнаружения атак.
💬

На что обратить внимание

Полезные наблюдения, которым пока не хватило места или самостоятельного вечернего опыта.

RAGу для программиста

Хабр✍ Даниил

AutoRAG и Qdrant: разделять dev/test по документам, затем повторно оценивать перенос выбранного retrieval-пайплайна. Численного доказательства улучшения в статье нет.

Читать ↗

RAG-бот по материалам эксперта: как я мерил качество поиска и почему гибрид оказался хуже чистого вектора

Хабр✍ Эмиль Мухаметзянов

Раздельная оценка retrieval и ответа: Recall@k и MRR помогают найти сбой до генерации. Нужна собственная разметка релевантности.

Читать ↗

Вайбкодинг: что дальше?

Хабр✍ Алексей Ширшов

PDCA для агентной задачи: план, исполнение, проверка и отдельное решение при отклонении. Метод полезнее обещаний от одного успешного прогона.

Читать ↗
🎯

Мой план на неделю

До среды: сравнить кандидата агента с baseline на одинаковых входах.
28 октября
До пятницы: проверить конфликт ручной правки между preview и записью файла.
30 октября
До воскресенья: проверить /status рабочего и личного Claude Code в панели и терминале.
1 ноября
#

Метаданные

собрано 2026-10-26T05:44:54.027377Z
окно 19–26 октября 2026, семь дней
отсканировано / в дайджесте 356 / 11
источник постраничный API Хабра: AI, ML, NLP и недельный топ
пропущенные ленты нет
отбор из 356 статей просмотрены заголовки 67 и полные тексты 21; основной выпуск — 8 практических материалов; недельный топ ограничен первыми 100 статьями
×
Открыть статью ↗